作品 · 2026
Code Review Agent.
把「AI 生成评论」做成可核验、可处理、可回滚的审查单元。
数据集 v1.4.0:80 条正例 + 44 条负例,全部逐条审计;模型 gpt-6-sol,温度 0.0。
01问题
使用 PR 流程的团队,合入前的审查依赖人工 Reviewer。三个结构性痛点:审查时间与开发节奏错位(作者被阻塞、Reviewer 被打断);低风险问题持续消耗高级工程师注意力;评论缺少可复现证据,作者不信任结论。
产品机会不是「再接一个模型入口」,而是把每个高风险问题变成可核验、可处理、可回滚的决策单元。
02做法
自研 Agent 循环
LLM → 工具 → 观测的显式循环;流式解析 tool call、进程级沙箱、按危险程度分级的 HITL 审批。不依赖 Agent 框架。
LangGraph 多 Agent
Plan → Send 并行验证 → Review 去重 → Fix → Verify。每一步都输出机器可读结构,可回放、可归因。
可复算的评测
124 条标注、逐条审计、逐样本 LLM 判分;口径、引用规则与局限写进基线文档,数字可复算。
03设计判断
三个决定,决定了这个产品长什么样。每条判断都能在仓库的决策记录里找到依据,界面只是它们的结果。
结果默认不阻塞合并
误报的代价高于漏报:一条错的「这里有注入」,会让 Reviewer 花二十分钟确认它是假的,然后开始不信任所有结论。所以结果只作审查输入,不作合并门禁——先让人愿意看,再谈自动化。
对应记录:产品决策记录 · 精确优先
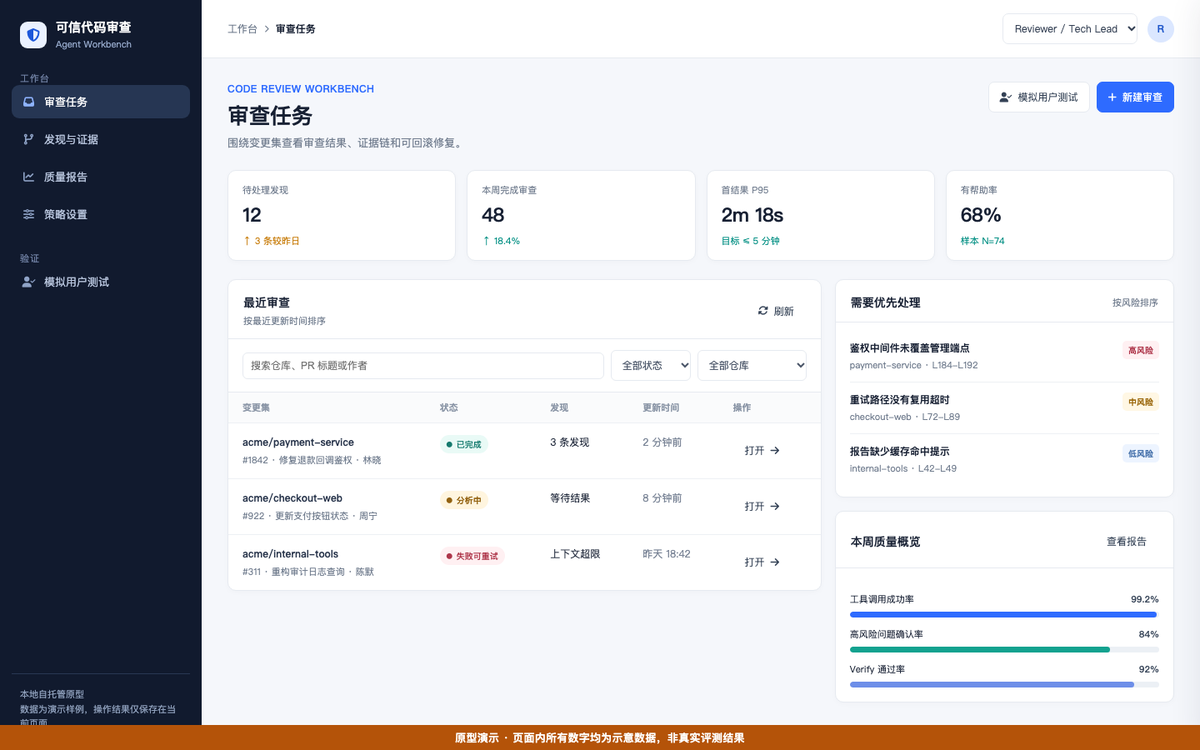
高危问题用确定性规则兜底
模型会漏,规则不会。高危缺陷在评测里是 4/4,但样本只有 4 条,置信区间下界刚过一半——不足以支撑「模型保证不漏」的承诺。所以在模型之外补一层确定性规则,两条腿走路。
对应记录:评测基线 · 严重度分层
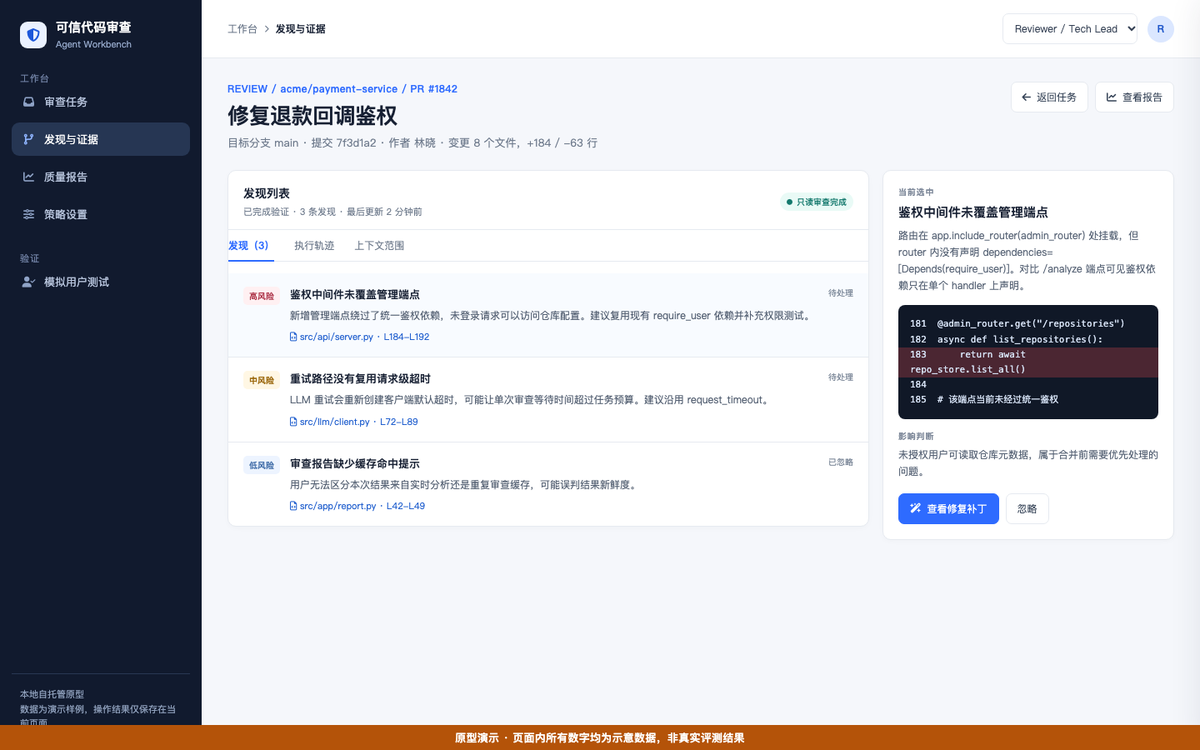
补丁只读优先,写前备份
自动改代码是不可逆动作。所以补丁默认只读预览,落到「应用」才写入,写前留 .bak;Verify 不做完,修复结果不算数。授权是逐步给的,不是一次性给满。
对应记录:HITL Guard 分级 · 修复流程
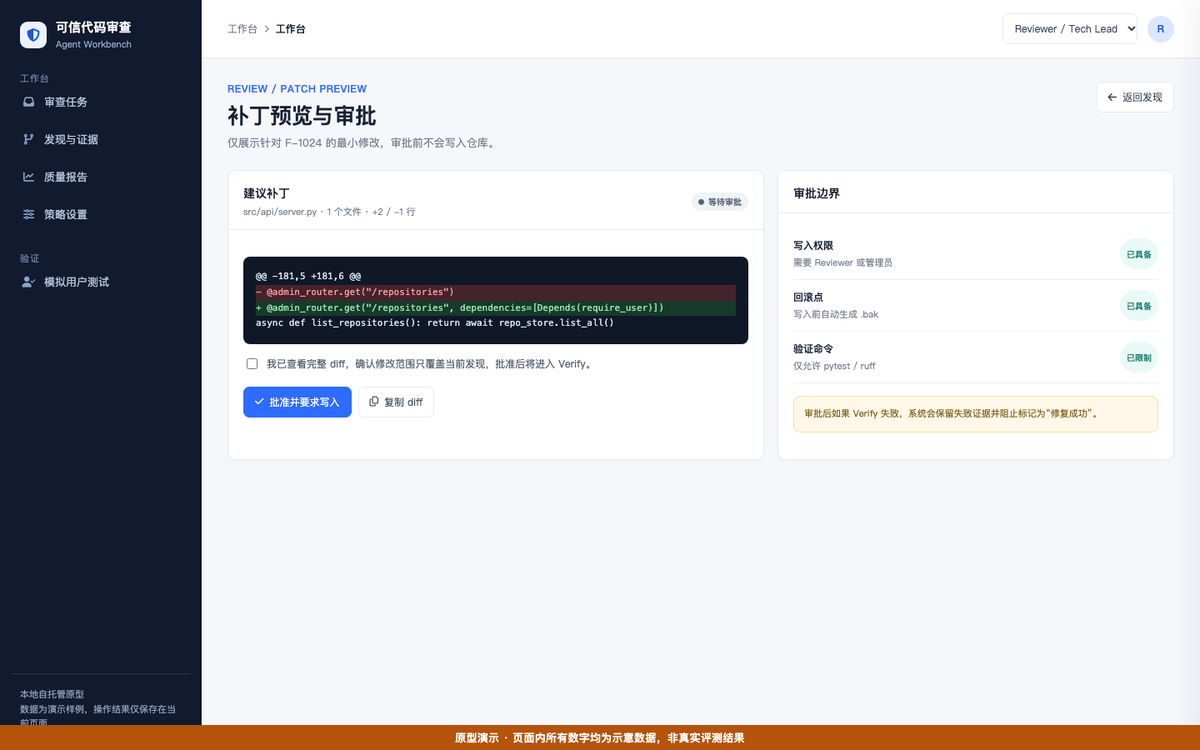
四个视图都能点:任务列表、发现与证据、补丁预览、质量报告。页面内数字为示意数据。
04边界
- 数据集是自建标注(124 条,来自第三方项目
llm-agent-qa-system),不是 SWE-bench 等公开基准,不可与业界数字横比。 - 总召回 51.2% 偏低:39 条漏报中 30 条属判据口径分歧(模型认为不该报、标注标准认为该报),仅 7 条是真实漏报。这是「精确优先」策略的结果,不是能力上限。
- 精确率曾从 94.0% 下修到 82.0%:独立审计发现 6 条标注标反。数字变小是修正的结果,不是模型退化。
- 原型与可用性测试均为模拟,未做真实客户试点与长期 ROI 证明。