完整笔记(含 16 阶段详解与 DOORS 实操)在 GitHub。
为什么整理这张图
工具链的难点从来不是“工具不够用”,而是边界不清:一件需求从提出到上线,经过六七个系统,每个系统都说“我管了”,出了问题却没人认领。
所以这份笔记只回答三个问题:
- 每个阶段谁是唯一主责
- 这个工具能做什么
- 这个工具做不到什么
四层结构
| 层次 | 工具 | 回答的问题 |
|---|---|---|
| ① 需求 / 项目 / 缺陷 | Jira、禅道、DOORS | 做什么?谁做?进度如何? |
| ② 代码与流水线 | GitLab、GitHub | 代码放哪?怎么评审?怎么自动构建? |
| ③ 制品仓库 | Nexus(包)、Harbor(镜像) | 构建产物存哪?怎么分发和管控? |
| ④ 运行环境 | Kubernetes | 跑在哪? |
需求进 Jira/禅道/DOORS → 代码进 GitLab → 包进 Nexus、镜像进 Harbor → 容器由 K8s 运行
                                          ↑
              SonarQube / Trivy / Vault / Terraform / Ansible(横切)
横切工具不占阶段,但每个阶段都会用到——这也是最容易被漏掉的一层。
三条铁律
| 铁律 | 含义 | 违反的后果 |
|---|---|---|
| 唯一主责 | 每个阶段有且只有一个工具/角色负责 | 责任真空,出问题互相甩锅 |
| 双向可追溯 | 任一需求能查到「从哪来、到哪去」 | 变更漏改,测试漏测 |
| 变更受控 | 改需求必须走流程、留痕迹 | 版本混乱,交付对不上 |
后面所有表格,本质上都是在回答“这条铁律靠什么工具落地”。
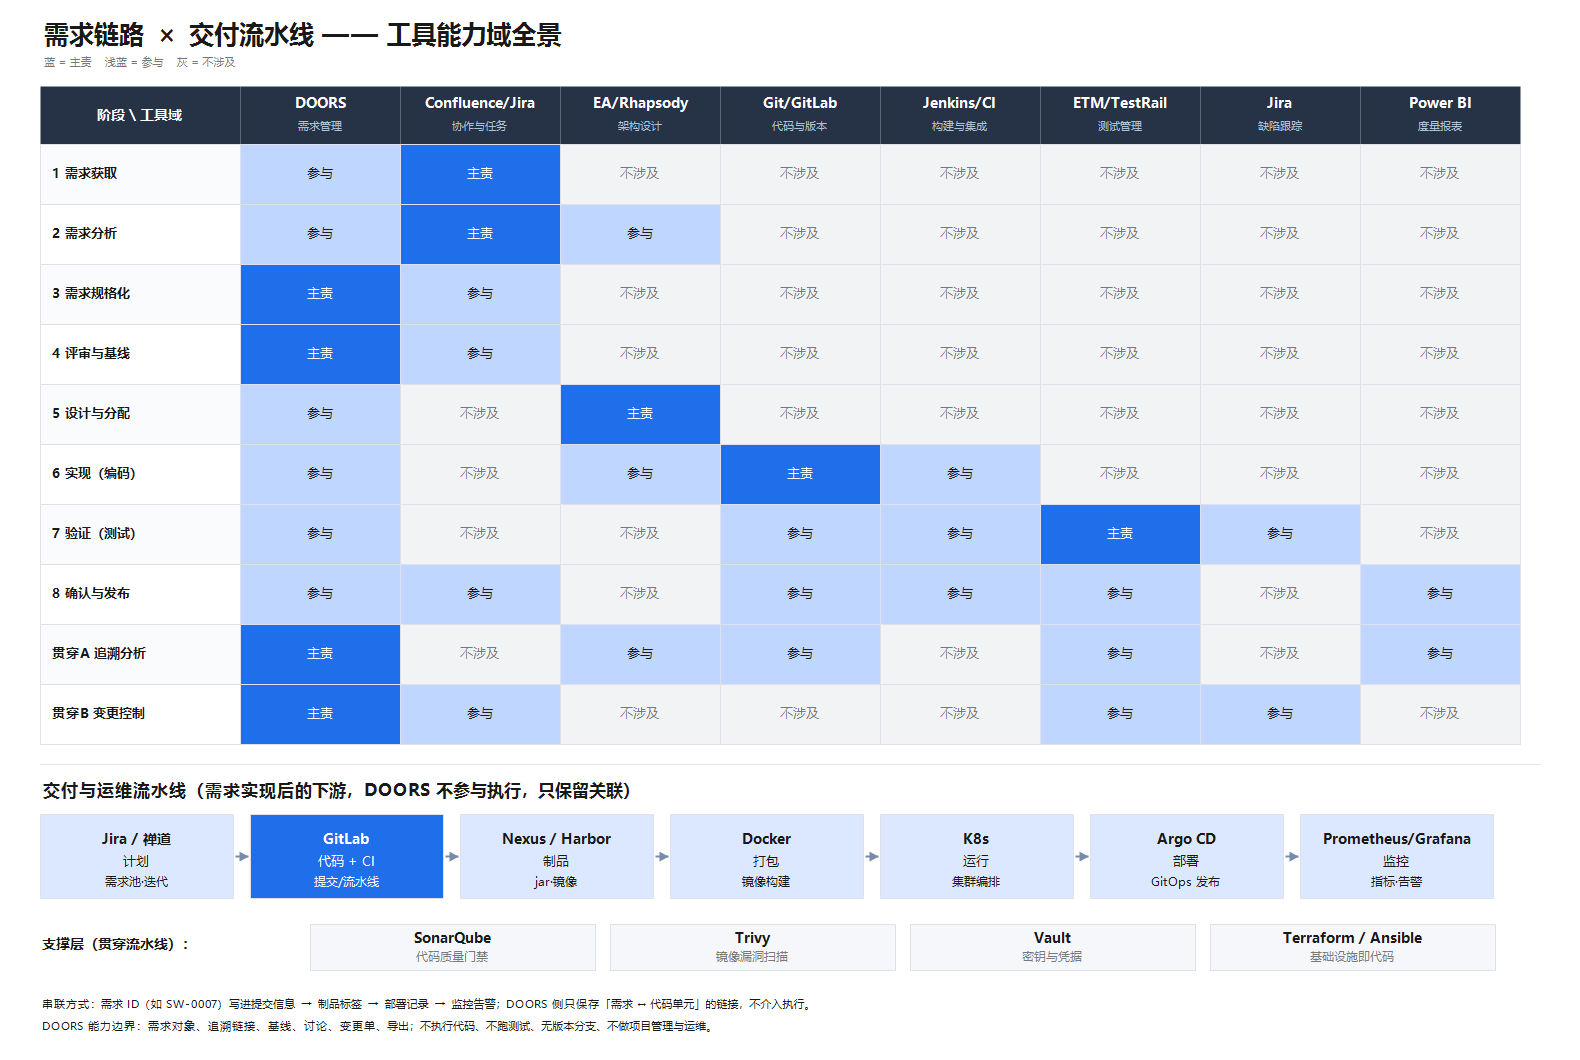
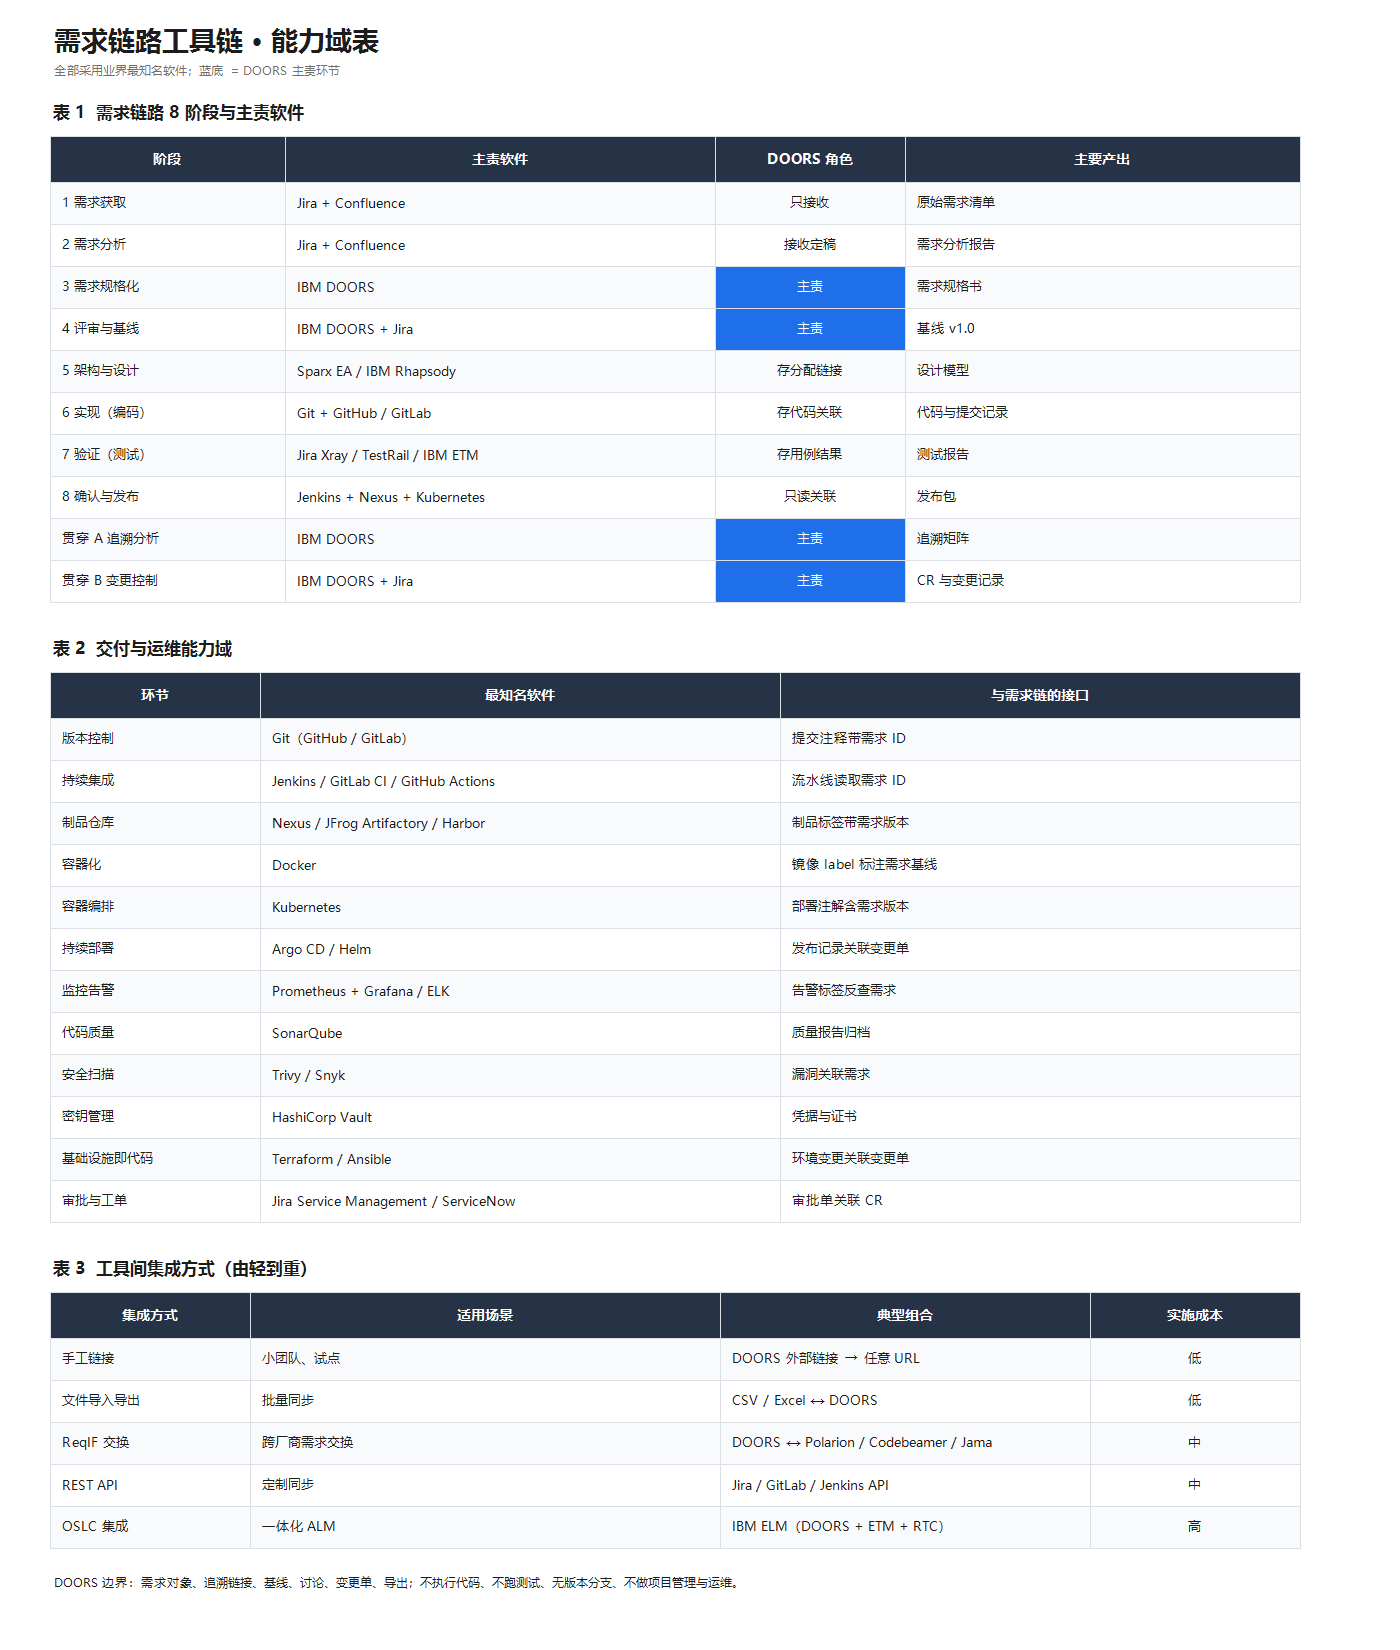
表 1 · 需求链路 8 阶段
| 阶段 | 主责软件 | 主要动作 | DOORS 的角色 | 产出物 |
|---|---|---|---|---|
| 1 需求获取 | Jira + Confluence | 需求池、访谈、干系人登记 | 只接收结果 | 原始需求清单 |
| 2 需求分析 | Jira + Confluence | 分类、优先级、冲突消解、评审 | 接收定稿 | 需求分析报告 |
| 3 需求规格化 | IBM DOORS | 编写 UR/SYS/SUB/SW,建立层级 | 主责 | 需求规格书 |
| 4 评审与基线 | IBM DOORS + Jira | 讨论留痕、评审结论、基线冻结 | 主责 | 基线 v1.0 |
| 5 架构与设计 | Enterprise Architect / Rhapsody | 架构图、组件划分、需求分配 | 保存分配链接 | 设计模型 |
| 6 实现(编码) | Git + GitHub / GitLab | 编码、提交、分支管理 | 保存代码关联 | 代码与提交记录 |
| 7 验证(测试) | Jira Xray / TestRail / IBM ETM | 用例设计、执行、缺陷登记 | 保存用例与结果 | 测试报告 |
| 8 确认与发布 | Jenkins + Nexus + Docker / K8s | 构建、制品、部署、验收 | 只读关联 | 发布包 |
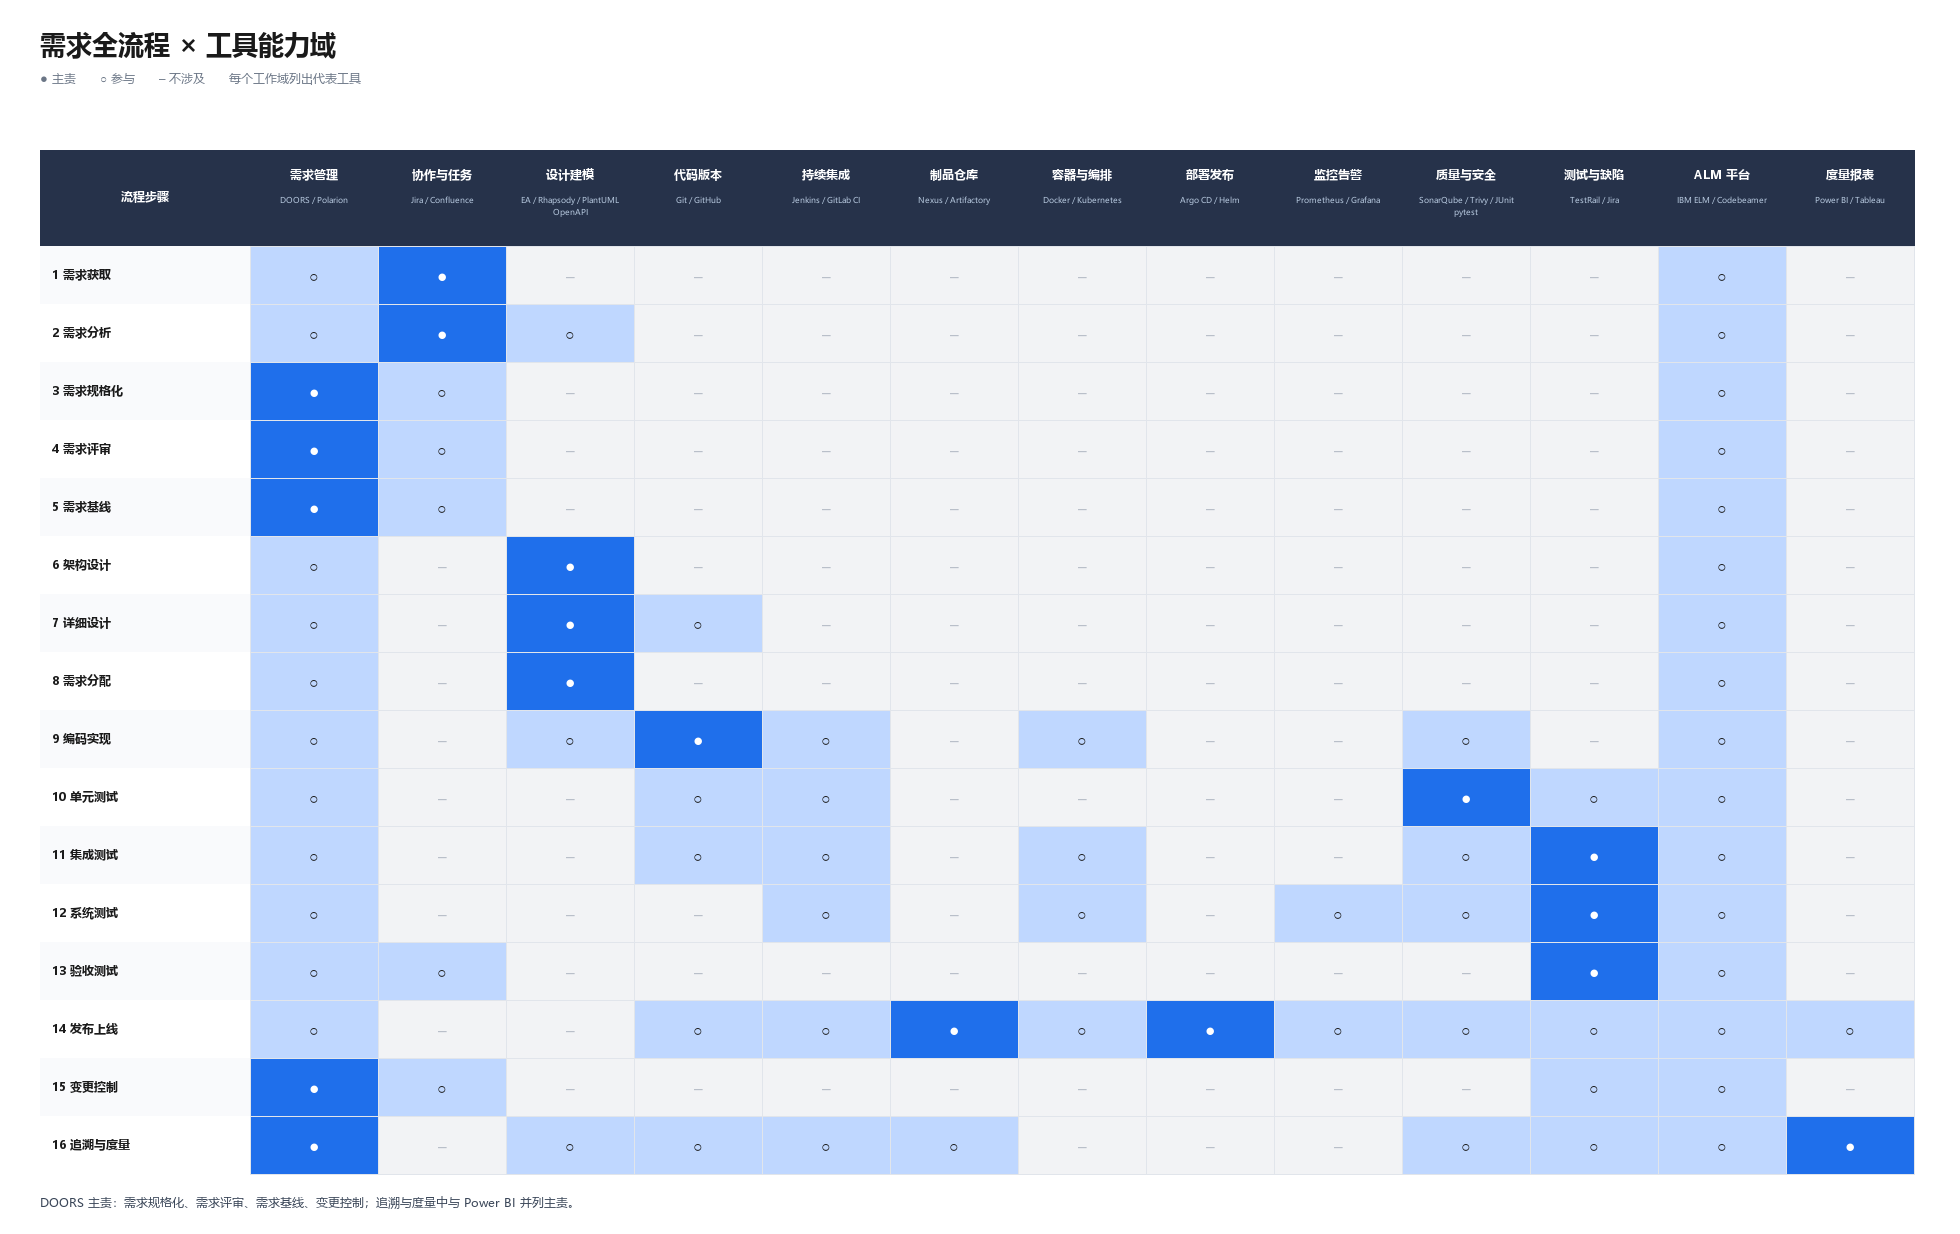
注意第 3、4 阶段:DOORS 只在这两步是主责,其余阶段它都是“接收方”或“只读方”。大多数人对 DOORS 的误解,就是把它当成全流程工具。
表 2 · 能力域(需求侧)
| 能力域 | 代表软件 | 定位 |
|---|---|---|
| 需求管理 | IBM DOORS、Polarion、Jama Connect | 需求库、追溯、基线 |
| 项目与任务 | Jira、Azure DevOps | 计划、迭代、看板 |
| 文档协作 | Confluence、SharePoint | 文档编写与评审 |
| 架构设计 | Enterprise Architect、Rhapsody、Cameo | UML/SysML 建模 |
| 测试管理 | Jira Xray、TestRail、IBM ETM | 用例、执行、覆盖 |
| 缺陷跟踪 | Jira、Bugzilla | 缺陷生命周期 |
| 度量报表 | Power BI、Tableau、Grafana | 指标看板 |
表 3 · 能力域(交付与运维侧)
| 环节 | 代表软件 | 作用 | 与需求链的接口 |
|---|---|---|---|
| 版本控制 | Git(GitHub / GitLab) | 代码与分支 | 提交注释带需求 ID |
| 持续集成 | Jenkins、GitLab CI、GitHub Actions | 构建、测试触发 | 流水线读取需求 ID |
| 制品仓库 | Nexus、Artifactory、Harbor | jar 与镜像存储 | 制品标签带需求版本 |
| 容器化 | Docker | 镜像打包 | 镜像 label 标注基线 |
| 容器编排 | Kubernetes | 集群调度 | 部署注解含需求版本 |
| 持续部署 | Argo CD、Helm | GitOps 发布 | 发布记录关联变更单 |
| 监控告警 | Prometheus + Grafana、ELK | 指标、日志、告警 | 告警标签反查需求 |
| 代码质量 | SonarQube | 静态扫描、质量门禁 | 质量报告归档 |
| 安全扫描 | Trivy、Snyk | 镜像/依赖漏洞 | 漏洞关联需求 |
| 密钥管理 | HashiCorp Vault | 凭据与证书 | 无 |
| 基础设施即代码 | Terraform、Ansible | 环境编排 | 环境变更关联变更单 |
最后一列是重点:每一行都要回答「它跟需求怎么对上」。对不上的环节,就是追溯链条的断点。
表 4 · 五种集成方式(由轻到重)
| 集成方式 | 适用场景 | 典型组合 | 成本 |
|---|---|---|---|
| 手工链接 | 小团队、试点 | DOORS 外部链接 → 任意 URL | 低 |
| 文件导入导出 | 批量同步 | CSV / Excel ↔ DOORS | 低 |
| ReqIF 交换 | 跨厂商需求交换 | DOORS ↔ Polarion / Codebeamer | 中 |
| REST API | 定制同步 | Jira / GitLab / Jenkins API | 中 |
| OSLC 集成 | 一体化 ALM | IBM ELM(DOORS + ETM + RTC) | 高 |
选型建议:先用 CSV 跑通,再谈 OSLC。很多团队一上来就想要一体化 ALM,结果卡在数据清洗上。
表 5 · DOORS 的能力边界
| DOORS 做 | DOORS 不做 |
|---|---|
| 需求对象与属性 | 执行代码、运行测试 |
| 追溯链接(需求↔需求↔工件) | 版本分支与合并(只有基线) |
| 基线与版本对比 | UML/SysML 建模 |
| 讨论与评审留痕 | 项目计划与工时 |
| 变更单与影响分析 | 缺陷生命周期管理 |
| 导出 Word / Excel / PDF / ReqIF | CI/CD 与部署 |
把“不做”这一列读一遍,就明白为什么它必须和 Jira、GitLab、EA 组合使用。
表 6 · 一条实操链路的真实体量
纸上谈兵容易,所以我在 DOORS 里把整条链路搭了一遍:
| 环节 | 实际位置 | 数量 |
|---|---|---|
| 用户/系统/子系统/软件需求 | DOORS 模块 | 725 条 |
| 追溯链接 | DOORS 链接模块 | 662 条 |
| 测试用例 | DOORS 模块 | 93 条 |
| 测试执行结果 | DOORS 模块 | 93 条 |
| 代码单元 | DOORS 模块 | 90 个 |
| 变更单 | DOORS 模块 | 15 张 |
| 代码仓库 / CI / 测试执行 | 未接入 | — |
数据是合成的,但链路是真的:CSV → DXL → 导入 → 校验,跑通一次之后,才知道“双向可追溯”在工程上意味着什么。
三张图
怎么读这份笔记
- 先建全局观:本页 + 四层结构
- 再走流程:16 个阶段逐个看「工具边界」和「常见坑」
- 最后动手:CSV → DXL → 导入 → 校验,跑通一遍
完整文档(16 阶段详解、DOORS 实操手册)在仓库里:
一句总结
工具链的价值不在于“用了多少工具”,而在于每个交接点都有人认领、每件产物都能回溯到需求。